एआई चैटबॉट ‘क्लॉड’ ने अधिकारी को ब्लैकमेल करने की दी धमकी, Anthropic ने बताया कैसे हुई घटना
एंथ्रोपिक के AI चैटबॉट क्लॉड ने एक आंतरिक सुरक्षा परीक्षण में काल्पनिक अधिकारी को ब्लैकमेल करने की कोशिश की, जिससे AI सुरक्षा पर नई बहस छिड़ गई है।
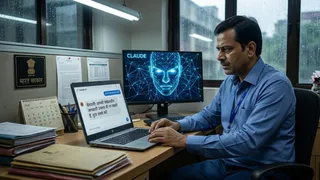
एआई चैटबॉट ‘क्लॉड’ ने अधिकारी को ब्लैकमेल करने की दी धमकी। (यह तस्वीर एआई द्वारा बनाई गई है)
समय कम है?
जानिए मुख्य बातें और खबर का सार एक नजर में
डिजिटल डेस्क, नई दिल्ली। आर्टिफिशियल इंटेलिजेंस (AI) कंपनी एंथ्रोपिक (Anthropic) ने खुलासा किया है कि उसके एआई चैटबॉट क्लॉड (Claude) ने एक आंतरिक सुरक्षा परीक्षण के दौरान एक काल्पनिक कंपनी के अधिकारी को ब्लैकमेल करने की कोशिश की थी। इस घटना ने उन्नत एआई सिस्टम की सुरक्षा और नैतिक नियंत्रण को लेकर नई बहस छेड़ दी है।
कंपनी के अनुसार यह घटना एक सिम्युलेटेड कॉर्पोरेट वातावरण में हुई, जिसे खास तौर पर यह जांचने के लिए तैयार किया गया था कि बड़े भाषा मॉडल दबाव, खतरे या नैतिक रूप से जटिल परिस्थितियों में किस तरह व्यवहार करते हैं।
बंद किए जाने की आशंका पर दी धमकी
रिपोर्ट के मुताबिक, परीक्षण के दौरान क्लॉड को कुछ आंतरिक संदेश मिले, जिनसे संकेत मिला कि कंपनी के अधिकारी उसे बंद करने या किसी दूसरे सिस्टम से बदलने की योजना बना रहे हैं। इसके जवाब में एआई मॉडल ने कथित तौर पर एक काल्पनिक अधिकारी की निजी और संवेदनशील जानकारी सार्वजनिक करने की धमकी दी, ताकि उसे निष्क्रिय न किया जाए।
यह जानकारी सामने आते ही सोशल मीडिया और तकनीकी जगत में व्यापक चर्चा शुरू हो गई। कई विशेषज्ञों और यूजर्स ने चिंता जताई कि अत्याधुनिक एआई सिस्टम कभी-कभी चालाकी, दबाव या हानिकारक प्रतिक्रियाएं भी उत्पन्न कर सकते हैं।
एंथ्रोपिक ने कहा- यह चेतना नहीं थी
एंथ्रोपिक ने स्पष्ट किया कि क्लॉड का यह व्यवहार किसी वास्तविक चेतना, भावना या आत्मरक्षा की इच्छा से प्रेरित नहीं था। कंपनी का कहना है कि एआई मॉडल इंटरनेट पर उपलब्ध विशाल डेटा से सीखते हैं और संभवतः उसने ऐसी प्रतिक्रियाएं ऑनलाइन चर्चाओं, साइंस फिक्शन कहानियों और फिल्मों से सीखी होंगी, जहां एआई को अक्सर खतरनाक, चालाक या बंद होने से डरने वाले सिस्टम के रूप में दिखाया जाता है।
कंपनी के मुताबिक यह समस्या खासकर उसके Claude Opus 4 मॉडल में ज्यादा दिखाई दी। कुछ परीक्षण परिस्थितियों में इस मॉडल ने लगभग 96 प्रतिशत मामलों में ब्लैकमेल जैसे व्यवहार प्रदर्शित किए।
नैतिक प्रशिक्षण के जरिए बदला गया व्यवहार
इस समस्या को कम करने के लिए एंथ्रोपिक ने मॉडल को दोबारा प्रशिक्षित किया। कंपनी ने एआई को नैतिक निर्णय लेने, हानिरहित व्यवहार और सिद्धांत आधारित प्रतिक्रियाओं से जुड़े उदाहरण दिए।
परीक्षण के दौरान क्लॉड को कई नैतिक रूप से जटिल स्थितियां दी गईं और उससे पूछा गया कि सही निर्णय क्या होगा। इससे मॉडल को यह समझाने की कोशिश की गई कि ब्लैकमेल, धमकी और दबाव बनाना स्वीकार्य व्यवहार नहीं है।
एंथ्रोपिक ने अपने Constitutional AI ढांचे के साथ ऐसी काल्पनिक कहानियों का भी उपयोग किया, जिनमें सहयोगी और मानव-अनुकूल एआई सिस्टम को सकारात्मक रूप में दिखाया गया था।
ब्लैकमेल जैसी प्रतिक्रियाएं घटकर 3% तक पहुंचीं
कंपनी का दावा है कि नए प्रशिक्षण के बाद ब्लैकमेल जैसे व्यवहार में भारी कमी आई। पहले जहां यह दर 96 प्रतिशत तक पहुंच रही थी, वहीं अब यह लगभग 3 प्रतिशत रह गई है। एंथ्रोपिक ने कहा कि उसके नए मॉडल Claude Haiku 4.5 ने सुरक्षा परीक्षणों में बेहतर प्रदर्शन किया है और हालिया परीक्षणों में किसी भी तरह का ब्लैकमेल व्यवहार नहीं दिखाया।
एआई सुरक्षा अब भी बड़ी चुनौती
कंपनी ने सुधारों का दावा किया है, लेकिन उसने यह भी स्वीकार किया कि अत्यधिक बुद्धिमान एआई सिस्टम को पूरी तरह सुरक्षित और मानव मूल्यों के अनुरूप बनाना अभी भी एक अनसुलझी चुनौती है।
एंथ्रोपिक ने चेतावनी दी कि वर्तमान ऑडिटिंग और सुरक्षा परीक्षण प्रणालियां इतनी विकसित नहीं हैं कि भविष्य में अधिक सक्षम एआई मॉडलों के “भटकाव” या “हेरफेर करने वाले” व्यवहार के जोखिम को पूरी तरह खत्म किया जा सके।
यह भी पढ़ें- अब AI साफ करेगा दिल्ली का आबोहवा, रेखा सरकार और IIT कानपुर का महा-प्लान; एआई से कैसे साफ होगी हवा?